Mission client · 2024
Modération IA
Traiter les contenus signalés dans une file humaine
Pré-modération par LLM sur une plateforme à publication ouverte
≈ 0,0005 $ d'analyse par annonce, texte et image compris · 1 administrateur · 4 approches évaluées
Résumé
- Problème
- Une plateforme d’annonces d’événements à publication ouverte, modérée par un seul administrateur non technique, devait écarter les contenus nocifs ou hors sujet sans retarder les organisateurs légitimes.
- Statut
- Mission client, mise en production en 2024.
- Rôle
- Conception, choix techniques et implémentation.
- Solution
- Un LLM multimodal analyse le titre, la description et l’image à la création. Ce qu’il signale rejoint la file où arrivent déjà les signalements des utilisateurs.
- Résultat
- Fonctionnalité livrée après des essais du client et d’un panel de testeurs sur des contenus réels. Coût des appels au modèle de l’ordre de 0,0005 $ par annonce.
- Limite
- L’analyse reste faillible : un contenu qu’elle ne signale pas est publié, puis reste exposé au signalement des utilisateurs. La décision finale appartient à l’administrateur.
Le besoin et le parcours d’un contenu
Le produit
Plateforme multilingue de découverte et de publication d'annonces d'événements, affichées en liste et sur une carte, filtrables par zone et par date. Les organisateurs, essentiellement des associations, des indépendants et de petites structures, créent eux-mêmes leurs fiches.
Une fiche est majoritairement composée de champs contraints : organisateur, type, date, lieu géolocalisé, tarif, liens de réservation. Trois champs seulement sont librement rédigés, le titre, la description et l'image. Le risque porte donc sur ces trois champs.
Le modèle repose sur la densité du catalogue, donc sur une publication ouverte : pas de validation préalable, pas de compte professionnel à faire valider. Au moment du projet, la plateforme ne proposait ni commentaires, ni profils publics, ni messagerie ; ces fonctionnalités figuraient dans les évolutions envisagées. Le signalement était réservé aux utilisateurs connectés, avec une notion de réputation et un bannissement par blocage d'adresse e-mail. Un administrateur unique, non technique, traitait la modération en plus du reste.
Le besoin
Les catégories de risque identifiées avec le client couvraient la violence, le contenu sexuel, la haine, le harcèlement, le langage offensant et le spam. Une catégorie supplémentaire s'y ajoutait, d'une nature différente : le contenu sans rapport avec le sujet de la plateforme, c'est-à-dire son détournement publicitaire.
C'est la plus fréquente au quotidien. L'audience de la plateforme est qualifiée et géolocalisée, donc utile à quiconque cherche à toucher ce public, y compris hors sujet. Elle pose aussi une question différente des précédentes. Savoir si un contenu est nocif est une question universelle, à laquelle des outils génériques répondent. Savoir s'il a sa place ici dépend de ce que la plateforme est censée héberger, et aucun outil générique ne le sait.
Deux facteurs aggravants : les annonces sont rattachées à une adresse et à une date réelles ; et la modération repose sur une seule personne.
Une seule file, deux sources
Le produit ne comporte pas deux dispositifs parallèles. Les signalements d'utilisateurs et l'analyse automatique alimentent la même file : quand le modèle juge un contenu suspect, il crée un signalement dans le canal existant plutôt qu'un objet séparé.
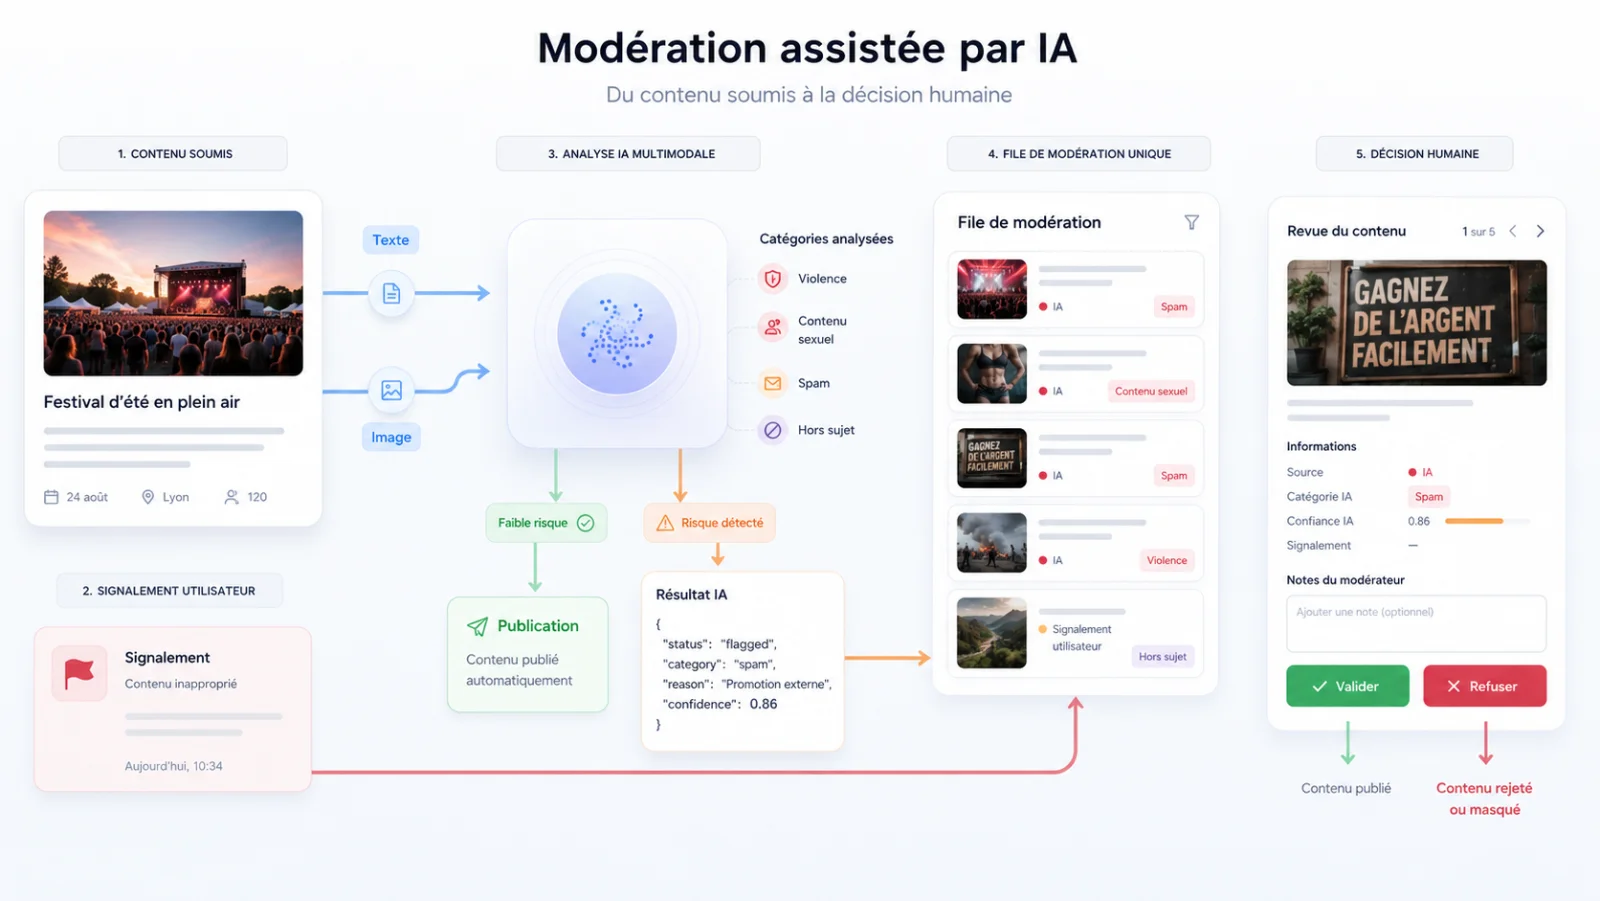
Une seule interface d'administration à construire et à maintenir. Un historique unique, donc une réputation exploitable quelle que soit l'origine de l'alerte. Un seul geste à apprendre pour le modérateur. Et la possibilité de couper le modèle s'il devient indisponible ou trop coûteux, le système retombant sur la modération humaine sans modifier le back-office.
Les commentaires et profils publics envisagés pour la suite s'y branchent comme une troisième source alimentant la même file, sans nouveau sous-système.
Publication et signalement
Les deux sources partagent la file, mais pas le même effet sur la visibilité de l'annonce.
Quand l'analyse automatique signale un problème à la création, l'annonce n'est pas mise en ligne : elle attend la revue de l'administrateur, qui la valide ou la refuse. Les contenus signalés par l'analyse sont donc retenus avant publication jusqu'à la revue humaine, et le coût pour l'organisateur se limite à une validation. Un contenu que l'analyse ne signale pas est publié, puis reste exposé au signalement des utilisateurs.
Quand un utilisateur signale une annonce déjà publiée, elle reste en ligne jusqu'à décision de l'administrateur. Sans cela, il suffirait à un concurrent ou à un utilisateur malveillant de signaler une annonce pour la faire disparaître, sans que personne n'ait rien vérifié.
L'état par défaut dépend donc de la source, parce que l'abus à empêcher n'est pas le même des deux côtés.
Décisions techniques
Les contraintes
Le client avait d'abord écarté l'IA pour des raisons de budget et préféré commencer manuellement. Le chiffrage du coût réel d'une analyse a rouvert la décision. Le volume était faible au démarrage, mais le modèle économique reposait sur la croissance du trafic : il fallait donc prévoir un volume à venir sans le payer tout de suite.
Les deux extrêmes étaient impraticables. Entièrement humaine, la modération impose un délai de publication, une charge continue, des traitements incohérents d'un jour à l'autre et aucune capacité d'absorption en cas de pic. Entièrement automatique, elle bloque des organisateurs légitimes sur une plateforme dont le contenu est la valeur, et ces organisateurs sont des associations et des indépendants qui ne relancent pas.
Les quatre approches évaluées
Liste noire de mots-clés. Gratuite et immédiate à écrire. Mais la plateforme est multilingue, il aurait fallu tenir une liste par langue. Le vocabulaire du domaine contient des termes qui paraissent problématiques hors contexte, donc beaucoup de blocages injustifiés. Une faute d'orthographe volontaire suffit à passer au travers. Et rien là-dedans ne détecte le hors-sujet.
Service de modération prêt à l'emploi, gratuit et maintenu par son fournisseur. Il repère les contenus nocifs, mais ne sait pas ce que la plateforme est censée héberger, donc ni le hors-sujet ni la publicité déguisée. Il ne traitait que le texte à cette période. Et il renvoie des scores par catégorie, pas une explication lisible par un modérateur non technique.
Modèle hébergé par nos soins. Les modèles ouverts disponibles n'étaient pas des classifieurs de modération mais des modèles à entraîner : il aurait fallu constituer un jeu d'exemples annotés, hors budget. Aucun ne traitait l'image, donc deux systèmes à maintenir au lieu d'un. Et faire tourner un modèle en continu revenait, à ce volume, plus cher que de payer les appels à une API.
Modèle généraliste appelé par API. Il comprend le contexte, peut juger le hors-sujet, traite le texte et l'image, et produit une explication lisible. Retenu.
Une première exploration avait porté sur le texte seul, et une autre sur un modèle hébergé localement.
La solution
Modèle
GPT-4o mini a été retenu pour analyser le texte et l’image dans un seul appel. À défaut, il aurait fallu maintenir deux chaînes de traitement, deux prompts et deux formats de réponse.
L'analyse de l'image n'était pas au périmètre initial, limité aux champs textuels. Elle a été ajoutée en cours de projet : un texte acceptable peut accompagner une image problématique, et l'image est l'élément visuel principal d'une fiche.
Cadrage du modèle
Un modèle généraliste ne sait pas ce que la plateforme héberge. Sans cadrage, il ne peut ni juger le hors-sujet, ni lire correctement le vocabulaire du domaine.
Le second point a demandé plusieurs itérations sur le prompt. Les intitulés d'événements emploient couramment un registre suggestif ou appuyé, à des fins d'accroche, sans que le contenu le soit. Lus isolément, ces termes déclenchent un signalement ; lus en sachant de quoi parle la plateforme, ils sont anodins. Le prompt système décrit donc ce que la plateforme héberge, ce qui y a sa place et ce qui n'y en a pas, et formule les catégories dans le vocabulaire du produit plutôt qu'en termes génériques.
C'est également ce qui rendait un service de modération prêt à l'emploi inutilisable ici : on ne peut pas lui expliquer de quoi parle la plateforme.
Contrat de sortie
Le modèle renvoie une réponse structurée dont le backend utilise les champs selon des règles définies.
{ "status": "pending_review", "category": "off_topic", "message": "La fiche ne décrit pas un événement mais une offre commerciale."}status est la seule valeur qui déclenche un changement d'état, et ses valeurs possibles sont peu nombreuses et fixées à l'avance. category sert au tri et au filtrage de la file. message n'est utilisé par aucun code : il s'affiche dans la file pour que le modérateur sache pourquoi une fiche est devant lui, sans rouvrir l'image et la description.
Injection de prompt
Le contenu analysé est écrit par l'utilisateur, qui peut y glisser une instruction destinée au modèle. La première mesure consiste à ne jamais mélanger les instructions et les données : le texte de l'utilisateur n'est pas inséré dans le message système, il est transmis à part, délimité et identifié comme tel. La réponse est ensuite vérifiée contre le format attendu, et toute réponse qui n'y correspond pas part vers la file humaine au lieu d'être approuvée. Ces mesures réduisent le risque sans l'écarter : un contenu rédigé pour tromper l'analyse peut ne pas être signalé. Il est alors publié comme les autres et reste soumis au signalement des utilisateurs.
Back-office
La file est exposée dans Active Admin, monté dans l'application Rails et servi depuis son propre domaine : liste filtrable, fiche détaillée, pagination et authentification générées à partir des modèles. L'effort de développement est allé au workflow, à la machine à états, à l'intégration du modèle et à la conservation des analyses.
Toute la chaîne reste dans l'application. Aucune donnée de modération ne passe par un tiers, et le nombre d'administrateurs n'a pas d'incidence sur les coûts. La seule sortie externe est l'appel au modèle, limité au titre, à la description et à l'image.
Machine à états, une seule file
Texte + image, sortie JSON structurée
File unique, décision humaine
Résultat et limites
Résultat
Fonctionnalité livrée avec le signalement utilisateur et la pré-modération automatique. Coût d'analyse de l'ordre de 0,0005 $ par annonce, texte et image compris : il s'agit du coût des appels au modèle, pas du coût total du service.
Système éprouvé avant mise en production par le client et un panel de testeurs, sur des contenus réels. Une annonce que l'analyse ne signale pas est publiée immédiatement ; seules les autres attendent une validation. La décision de refuser une annonce reste humaine, et chaque analyse comme chaque décision sont conservées.